AUTORIZĀCIJA
Blogs
Kas ir infrastruktūras monitorings uzņēmumā?
Darbinieki nevar piekļūt failiem, e-pasts kavējas, klientu sistēma kļūst lēna. Šādos brīžos jautājums nav tikai par to, kas salūzis, bet arī par to, cik ilgi uzņēmums jau zaudē darba laiku, ieņēmumus un klientu uzticību. Kas ir infrastruktūras monitorings? Tā ir nepārtraukta IT vides uzraudzība, kas palīdz pamanīt tehniskas novirzes, pirms tās pārvēršas par uzņēmējdarbību traucējošu incidentu.
Mazā un vidējā uzņēmumā IT problēma reti paliek tikai IT problēma. Ja nestrādā noliktavas sistēma, kavējas piegādes. Ja nav pieejams grāmatvedības risinājums, tiek aizturēti rēķini. Ja pārtrūkst attālinātā piekļuve, komanda nevar turpināt darbu. Tāpēc monitorings nav tikai rīks administratoriem - tas ir darbības nepārtrauktības vadības elements.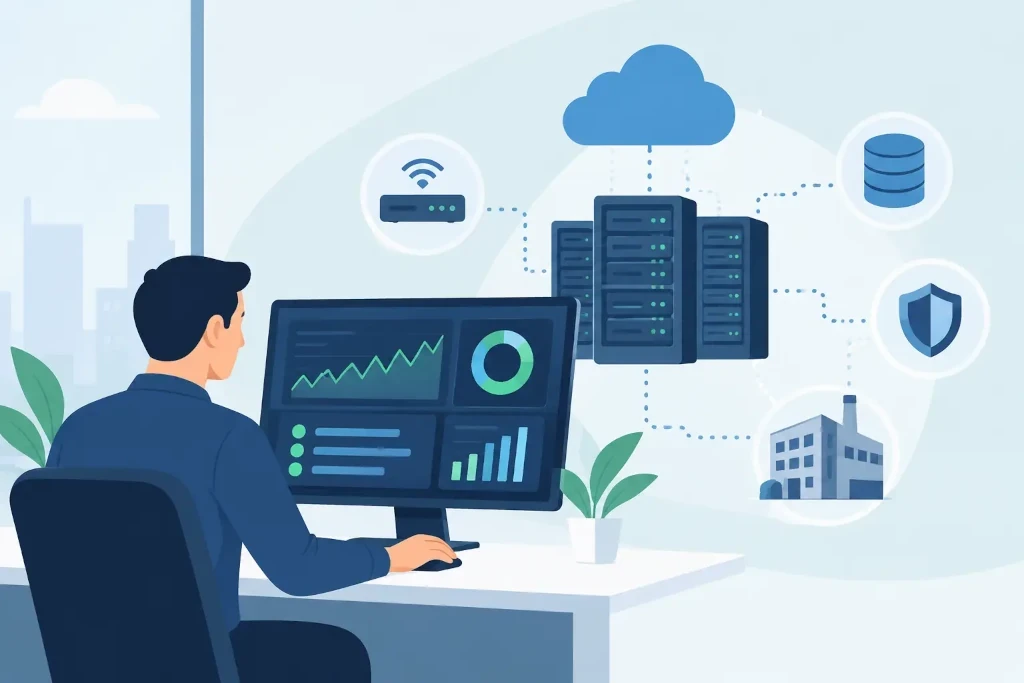
Kas ir infrastruktūras monitorings un ko tas aptver
Infrastruktūras monitorings ir serveru, tīkla, darba staciju, mākoņpakalpojumu, datu glabātuves un kritisko biznesa lietojumprogrammu stāvokļa mērīšana un analīze. Monitoringa sistēma regulāri pārbauda noteiktus parametrus, salīdzina tos ar pieļaujamām robežām un nosūta brīdinājumu atbildīgajai komandai, ja parādās risks vai kļūme.
Praksē tas var nozīmēt, ka IT speciālists saņem paziņojumu par diska vietas izsīkšanu vēl pirms serveris pārstāj pieņemt jaunus datus. Tāpat var tikt konstatēta neparasti augsta procesora noslodze, nestabils interneta savienojums, nepieejama VPN piekļuve vai neveiksmīgi rezerves kopiju uzdevumi. Mērķis nav vienkārši savākt daudz tehnisku datu. Mērķis ir savlaicīgi pieņemt pamatotu rīcību.
Efektīvs monitorings aptver gan lokālo infrastruktūru birojos un datu centros, gan publiskā mākoņa resursus, piemēram, virtuālos serverus un identitātes pakalpojumus. Hibrīdā vidē tas ir īpaši būtiski, jo traucējuma cēlonis var atrasties jebkurā ķēdes posmā: lietotāja ierīcē, tīklā, piegādātāja servisā vai integrācijā starp sistēmām.
Kāpēc ar reaģēšanu pēc lietotāju sūdzībām nepietiek
Uzņēmumos bez organizēta monitoringa IT problēmas bieži tiek pamanītas tikai tad, kad kāds nespēj veikt savu darbu. Šāda pieeja ir reaktīva. Tā liek komandai meklēt cēloni laikā, kad spiediens jau ir augsts un biznesa process ir apstājies.
Proaktīvs monitorings maina šo secību. Tā vietā, lai gaidītu, kad serveris pilnībā apstāsies, IT komanda redz tendenci: atmiņas patēriņš pieaug, diska vieta samazinās vai tīkla kļūdu skaits pārsniedz normu. Tas dod laiku veikt plānotu labojumu, palielināt resursus, nomainīt komponenti vai pielāgot konfigurāciju ārpus kritiskā darba laika.
Tomēr monitorings negarantē, ka nekad nebūs incidentu. Aparatūra var negaidīti atteikt, ārējs pakalpojums var būt nepieejams, bet kiberuzbrukums var radīt situāciju, kas prasa plašāku reaģēšanu. Monitoringa vērtība ir spēja ātrāk konstatēt problēmu, precīzāk novērtēt tās ietekmi un mazināt dīkstāves ilgumu.
Kādi rādītāji ir svarīgi uzņēmuma darbībai
Ne katrs tehniskais mērījums ir vienādi nozīmīgs. Pārāk daudz brīdinājumu rada tā saukto trauksmju nogurumu - kritiski paziņojumi pazūd starp mazsvarīgiem signāliem. Tāpēc uzraudzības modelim jābūt balstītam uz pakalpojumu prioritātēm un uzņēmuma riskiem.
Parasti tiek uzraudzīta serveru pieejamība, procesora un operatīvās atmiņas noslodze, diska vieta, datu glabātuves veiktspēja, tīkla savienojumu kvalitāte un ugunsmūru stāvoklis. Tikpat svarīgi ir pārbaudīt, vai darbojas rezerves kopiju izveide, vai tās ir veiksmīgas un vai nepieciešamības gadījumā datus var atjaunot. Rezerves kopija, kas eksistē tikai atskaitē, bet nav atjaunojama, nenodrošina reālu aizsardzību.
Biznesa kritiskajām sistēmām jāuzrauga ne vien serveris, uz kura tās darbojas, bet arī pats pakalpojums. Piemēram, nepietiek zināt, ka virtuālā mašīna ir ieslēgta. Jāpārbauda, vai lietojumprogramma pieņem pieprasījumus, datubāze atbild un galvenais darījuma process lietotājiem tiešām ir pieejams.
Monitorings, drošība un rezerves kopijas
Infrastruktūras monitorings nav pilnvērtīgs kiberdrošības aizvietotājs. Tas pats par sevi neaptur pikšķerēšanu, neievieš piekļuves kontroles un neaizstāj ievainojamību pārvaldību. Taču tas ir būtisks drošības slānis, jo palīdz pamanīt aizdomīgas izmaiņas un nestandarta sistēmu uzvedību.
Piemēram, neparasti straujš failu izmaiņu apjoms, negaidīta servera resursu noslodze vai kritiska pakalpojuma pārstartēšanās var liecināt par ļaunprogrammatūru, kļūdainu atjauninājumu vai neautorizētu darbību. Lai šāds signāls būtu vērtīgs, tam jānonāk pie cilvēka vai komandas, kas prot izvērtēt situāciju un rīkoties pēc skaidra incidentu procesa.
Saikne ar katastrofu atkopšanas plānu ir tieša. Monitorings parāda, ka ir radies traucējums; rezerves kopijas un atkopšanas procedūras ļauj atjaunot darbu; savukārt regulāri testi pierāda, vai plāns strādā arī reālā spiediena situācijā. Uzņēmumam ir vajadzīgas visas trīs daļas, nevis tikai viena no tām.
Kā ieviest monitoringu bez pārmērīgas sarežģītības
Sākumpunkts ir kritisko pakalpojumu kartēšana. Vadībai un IT atbildīgajiem jāvienojas, kuras sistēmas uzņēmums nevar zaudēt pat uz dažām stundām, kuras var būt nepieejamas ilgāk un kāda ietekme rodas katrā scenārijā. Šis vērtējums nosaka, ko uzraudzīt vispirms un cik ātri jāreaģē.
Pēc tam jādefinē mērījumi, brīdinājumu sliekšņi un atbildība. Brīdinājums par servera nepieejamību naktī ir bezjēdzīgs, ja nav skaidrs, kas to saņem, cik ātri jāreaģē un kādā kārtībā jāiesaista piegādātāji vai uzņēmuma vadība. Atbildības sadalījums ir tikpat nozīmīgs kā izvēlētā tehnoloģija.
Vēlams sākt ar svarīgāko, nevis uzreiz uzraudzīt katru iespējamo parametru. Parasti pirmajā posmā ietilpst interneta pieslēgums, ugunsmūris, serveri, rezerves kopijas, e-pasts, piekļuve failiem un centrālās biznesa sistēmas. Kad tiek iegūti pirmie dati, monitoringa konfigurāciju var pilnveidot, novēršot liekus paziņojumus un pievienojot detalizētāku analīzi.
Svarīga ir arī regulāra atskaišu pārskatīšana. Ikmēneša pārskats var atklāt atkārtotus savienojuma traucējumus, resursu jaudas nepietiekamību vai sistēmas, kuras bieži tuvojas kritiskām robežām. Šie novērojumi ļauj plānot budžetu un infrastruktūras uzlabojumus, nevis iegādāties risinājumus steidzamā avārijas režīmā.
Kad vajadzīgs pārvaldīts monitorings
Iekšējā IT komanda var pārvaldīt monitoringu, ja tai ir pietiekama kapacitāte, nepieciešamās prasmes un skaidrs dežūru modelis. Taču mazākās organizācijās viens IT speciālists bieži vienlaikus atbalsta lietotājus, uztur sistēmas, īsteno projektus un koordinē piegādātājus. Pastāvīga uzraudzība šādā situācijā var palikt otrajā plānā.
Pārvaldīts monitorings ir piemērots, ja uzņēmumam nepieciešama regulāra uzraudzība un eskalācija, bet nav lietderīgi veidot pilna laika komandu šim uzdevumam. Ārējs IT partneris var apvienot tehnisko uzraudzību ar incidentu novēršanu, jaudas plānošanu, rezerves kopiju kontroli un vadībai saprotamu pārskatāmību. KSK IT šādu pieeju sasaista ar plašāku infrastruktūras pārvaldību un biznesa nepārtrauktības prasībām.
Izvērtējot pakalpojumu, jautājiet ne tikai par uzraugāmo ierīču skaitu. Noskaidrojiet, kas analizē brīdinājumus, kāds ir reakcijas laiks, kā tiek pārbaudītas rezerves kopijas, kā notiek eskalācija un kādu informāciju regulāri saņems vadība. Lēts risinājums, kas tikai nosūta automātiskus e-pastus, ne vienmēr samazina uzņēmuma risku.
Monitorings kļūst vērtīgs tad, kad tas pārvērš tehniskus signālus praktiskos lēmumos: ko labot tagad, ko plānot nākamajā ceturksnī un kur uzņēmuma darbība ir visvairāk pakļauta riskam. Sāciet ar kritiskāko pakalpojumu skaidru sarakstu un pārbaudiet, vai par katru no tiem kāds uzzinātu pirms to pamana klients vai darbinieks.
