АВТОРИЗАЦИЯ
Блог
Как сократить IT-простой без потерь для бизнеса
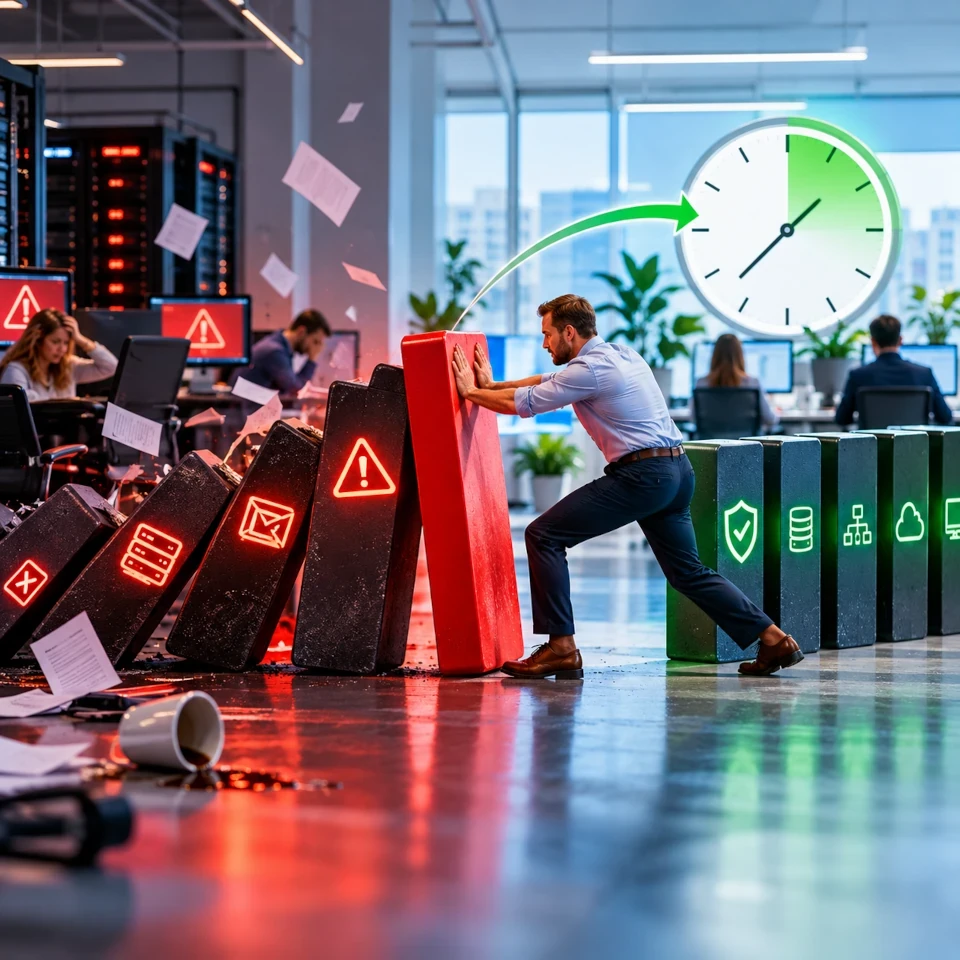
В понедельник утром не работает доступ к клиентской системе, склад не может обрабатывать заказы, а финансовая команда не получает доступ к счетам. В такой ситуации вопрос о том, как сократить простой IT, уже не является только технической задачей. Это вопрос выручки, репутации, производительности сотрудников и способности компании выполнять обещания клиентам.
Простой IT не всегда означает полный отказ серверов или интернета. Это может быть медленная бизнес-система, недоступное облако, заблокированная учетная запись пользователя, поврежденный сетевой компонент или неудачное обновление программного обеспечения. Эффективный подход не основан на одном инструменте или большем IT-бюджете. Он начинается с четкого определения приоритетов, прозрачной ответственности и регулярно проверяемого плана непрерывности.
Стоимость простоя IT нужно оценивать языком бизнеса
Затраты на простой складываются не только из рабочих часов IT-специалиста или цены нового оборудования. Нужно учитывать необработанные заказы, задержанные платежи, простаивающий персонал, потерю доверия клиентов и возможные штрафы по договорам. Для компании с небольшой командой даже двухчасовой перерыв может создать значительную операционную нагрузку, потому что нет людей, которые параллельно могли бы поддерживать ручной рабочий процесс.
Поэтому первый шаг — определить, какие системы критичны и как долго компания может обходиться без каждой из них. Электронная почта обычно важна, но для производственной компании критичнее может быть система управления складом. Для компании, оказывающей профессиональные услуги, наибольший риск может заключаться в потере доступа к документам клиентов. Приоритеты не может определять только IT-отдел — их должны утверждать руководство и владельцы процессов.
Определите цели восстановления
Для каждого важного сервиса нужно установить два практических показателя. Цель времени восстановления определяет, как быстро система должна вернуться в работу после инцидента. В свою очередь, допустимый объем потери данных определяет, насколько старыми могут быть данные в точке восстановления.
Например, для системы заказов клиентов может потребоваться восстановление работы в течение одного часа и потеря данных не более чем за 15 минут. Для архива файлов может быть допустимо более длительное время восстановления. Это различие существенно, поскольку обеспечить одинаковый уровень защиты для всех систем дорого и не всегда оправданно.
Как сократить простой IT с помощью проактивного мониторинга
Многие отказы начинаются с небольших сигналов: растет нагрузка на диск, падает качество интернет-соединения, резервный блок питания сервера теряет мощность или резервная копия завершается с ошибкой. Если компания узнает о проблеме только тогда, когда сотрудник не может подключиться к системе, реакция уже запоздала.
Проактивный мониторинг позволяет заметить отклонения до того, как они перерастут в инцидент. Он должен охватывать не только серверы, но и сетевое оборудование, интернет-соединения, доступность облачных сервисов, статус резервных копий, события безопасности и работу критических приложений. Важно не собрать как можно больше оповещений, а определить, какие из них требуют немедленных действий и кому они эскалируются.
Мониторинг особенно ценен для компаний без большой внутренней IT-команды. Он обеспечивает, что состояние инфраструктуры не проверяется только по жалобам пользователей или при регулярных визитах. Вместе с тем сама система мониторинга не решает проблемы — нужен ответственный, который реагирует на уведомление, анализирует причину и предотвращает повторение.
Резервные копии — не план восстановления
Резервная копия — это основа, но она не гарантирует быстрого возобновления работы. Если копии не проверялись, неясно, есть ли в них нужные данные, сработает ли восстановление и сколько времени оно займет. В инцидентах с ransomware риск еще выше — злоумышленники могут попытаться зашифровать или удалить и доступные резервные копии.
Практический подход предусматривает несколько слоев защиты: регулярные копии, отдельную среду хранения, контроль доступа и проверенную процедуру восстановления. Для критических систем может также потребоваться неизменяемая копия, которую в течение определенного времени нельзя модифицировать или удалить. Такое решение увеличивает затраты, но снижает вероятность того, что во время киберинцидента будут потеряны и рабочие, и резервные версии данных.
Тест восстановления — одна из самых ценных мер контроля непрерывности. Это может быть простой тест восстановления файла или полноценный сценарий восстановления критической системы в изолированной среде. Во время теста часто выявляются неполные инструкции, отсутствующие права доступа, неподходящие лицензии или слишком оптимистичные предположения о времени восстановления.
Снижайте риск во время изменений
Планируемые изменения — частая причина простоя. Новый межсетевой экран, изменение конфигурации Microsoft 365, обновление ERP или миграция серверов могут улучшить среду, но только если изменения управляются дисциплинированно. Спешка и неполная документация обычно обходятся дороже, чем тщательная подготовка.
Перед существенными изменениями нужно оценить влияние на связанные системы, подготовить план возврата и назначить ответственных лиц. Изменения, затрагивающие работу клиентов, рекомендуется планировать вне наиболее активного рабочего времени, однако и это не универсальное решение. Для компании с международными клиентами или непрерывным производственным процессом может не быть полностью безопасного временного окна. Поэтому решающее значение имеет способность быстро вернуться к предыдущей, рабочей конфигурации.
Регулярная документация инфраструктуры здесь — практическая необходимость, а не бюрократия. Актуальная схема сети, список систем, распределение ответственности за доступ и обзор лицензий ускоряют устранение инцидента. Если важная информация хранится только в знаниях одного сотрудника, компания уязвима даже тогда, когда технологии работают безупречно.
Создайте порядок управления инцидентами
Во время простоя команде не следует импровизировать, кому звонить и кого информировать. Порядок управления инцидентами определяет, кто принимает решения, кто координирует техническую работу, как информируются пользователи и когда нужно привлекать внешних поставщиков. Чем больше неопределенности в коммуникации, тем дольше может продолжаться фактический простой.
Порядок должен быть достаточно простым, чтобы использовать его в стрессовой ситуации. В нем нужно указать контактные лица, приоритеты критических систем, уровни эскалации и шаблоны сообщений для сотрудников или клиентов. Не нужно превращать каждый инцидент в масштабный кризис, но своевременная и честная информация снижает спекуляции и помогает бизнес-командам адаптировать работу.
После инцидента следует провести краткий, структурированный анализ. Цель — не найти виновного, а понять причину, оценить качество реакции и определить конкретное улучшение. Если у одного и того же пользователя регулярно возникают проблемы с доступом, если повторяются ошибки резервного копирования или периодически перезагружается сетевое оборудование, это вопрос управления, а не отдельные не связанные между собой случаи.
Привлеките соответствующую компетенцию и управленческий обзор
Для малых и средних организаций не всегда экономически оправдано содержать полноценную внутреннюю IT-команду с компетенциями в инфраструктуре, кибербезопасности, облачных сервисах и непрерывности. Но риск не исчезает, если этих навыков нет в компании. В такой ситуации управляемая IT-поддержка и внешняя компетенция в IT-управлении могут обеспечить как ежедневный мониторинг, так и стратегический взгляд на риски и инвестиции.
Подход KSK IT в таких проектах основан на оценке среды, согласовании приоритетов с руководством и плане измеримых улучшений. Это может включать аудит резервных копий, сценарий восстановления после катастрофы, модернизацию сети или упорядочение ответственности между несколькими поставщиками. Решающее значение имеет то, чтобы IT-партнер понимал не только техническую конфигурацию, но и то, где простой оказывает наибольшее влияние на бизнес.
Руководство должно регулярно получать краткий, понятный отчет: какие инциденты произошли, какова была их продолжительность, какие риски выявлены и какие решения необходимы. Такая прозрачность помогает принимать обоснованные решения об инвестициях, не дожидаясь следующего серьезного отказа.
Лучшее время проверить готовность компании — не после инцидента, а до него. Выберите одну критическую систему, обсудите сценарий ее отказа с владельцем процесса и проверьте, задокументированы ли и практически выполнимы ли ответы на ключевые вопросы. Этот небольшой шаг часто становится началом значительно более безопасной и предсказуемой IT-среды.
